Neste artigo
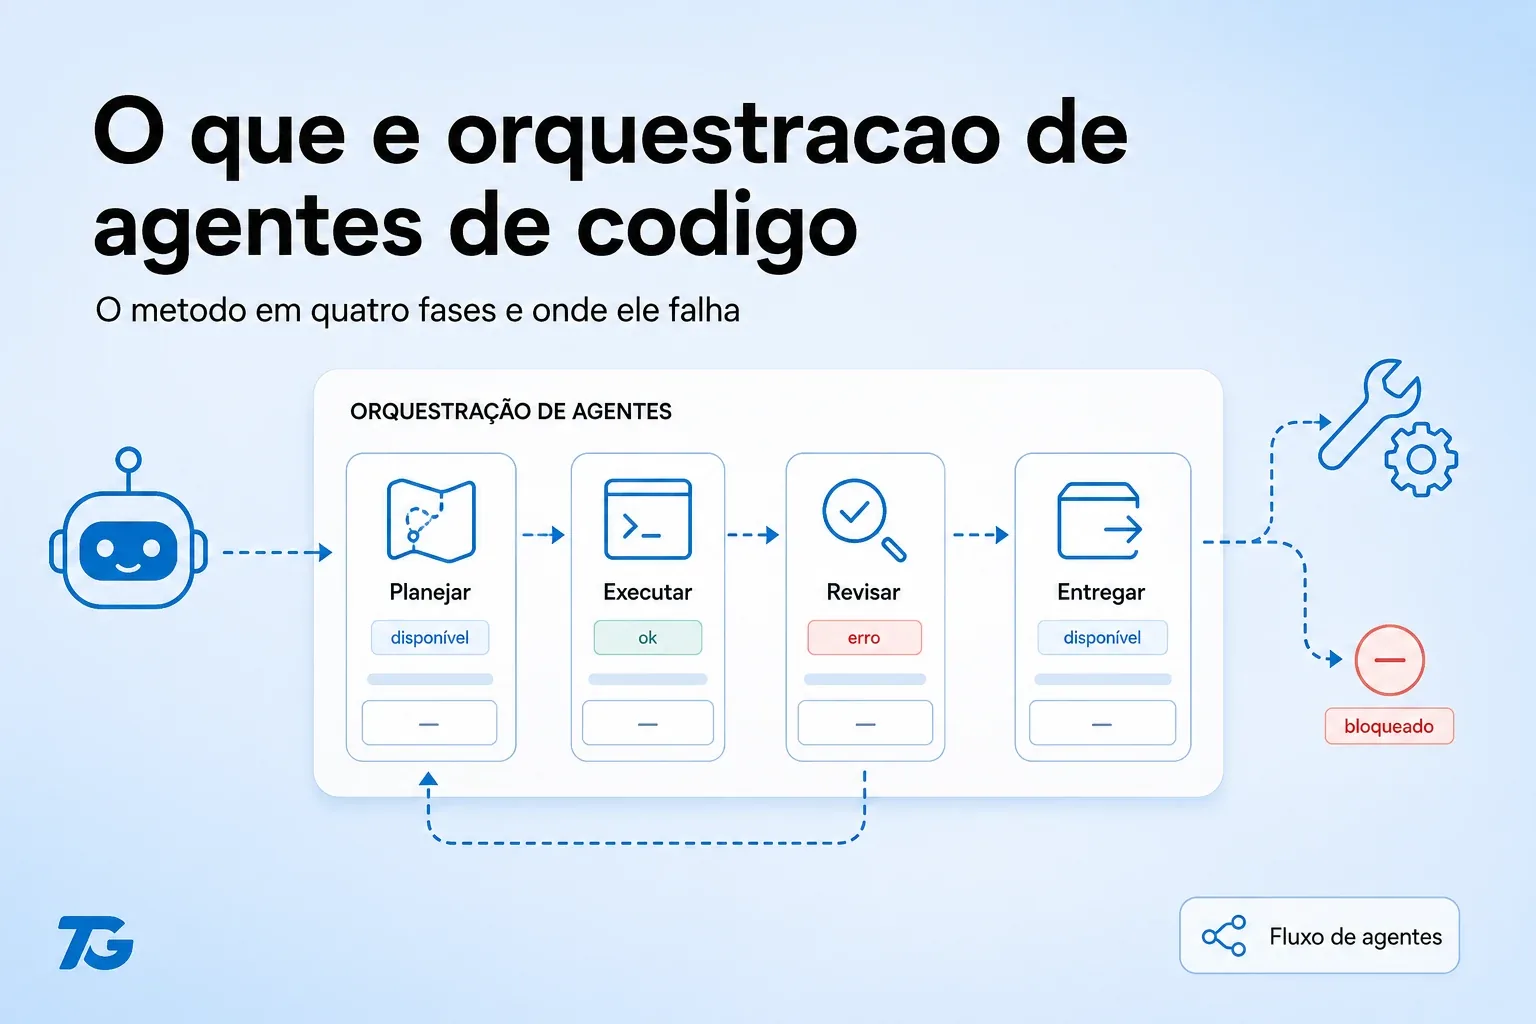
Orquestração de agentes de código é o trabalho de dirigir dois ou mais agentes de IA por um processo com especificação escrita, raias separadas e prova automática. Quem orquestra decide o que construir, define como aquilo será verificado e revisa por evidência em vez de ler linha a linha. É o oposto do vibe coding, que aceita o resultado porque a tela abriu e o erro só aparece em produção.
Eu sou Thales Gomes, desenvolvedor em Florianópolis, e trabalho assim todos os dias construindo software para clientes e para produtos próprios. Este texto descreve o método inteiro sem a parte de marketing, incluindo onde ele falha. A ideia não é vender que existe um atalho, é mostrar o processo que torna o trabalho de agente confiável o bastante para entrar em produção.
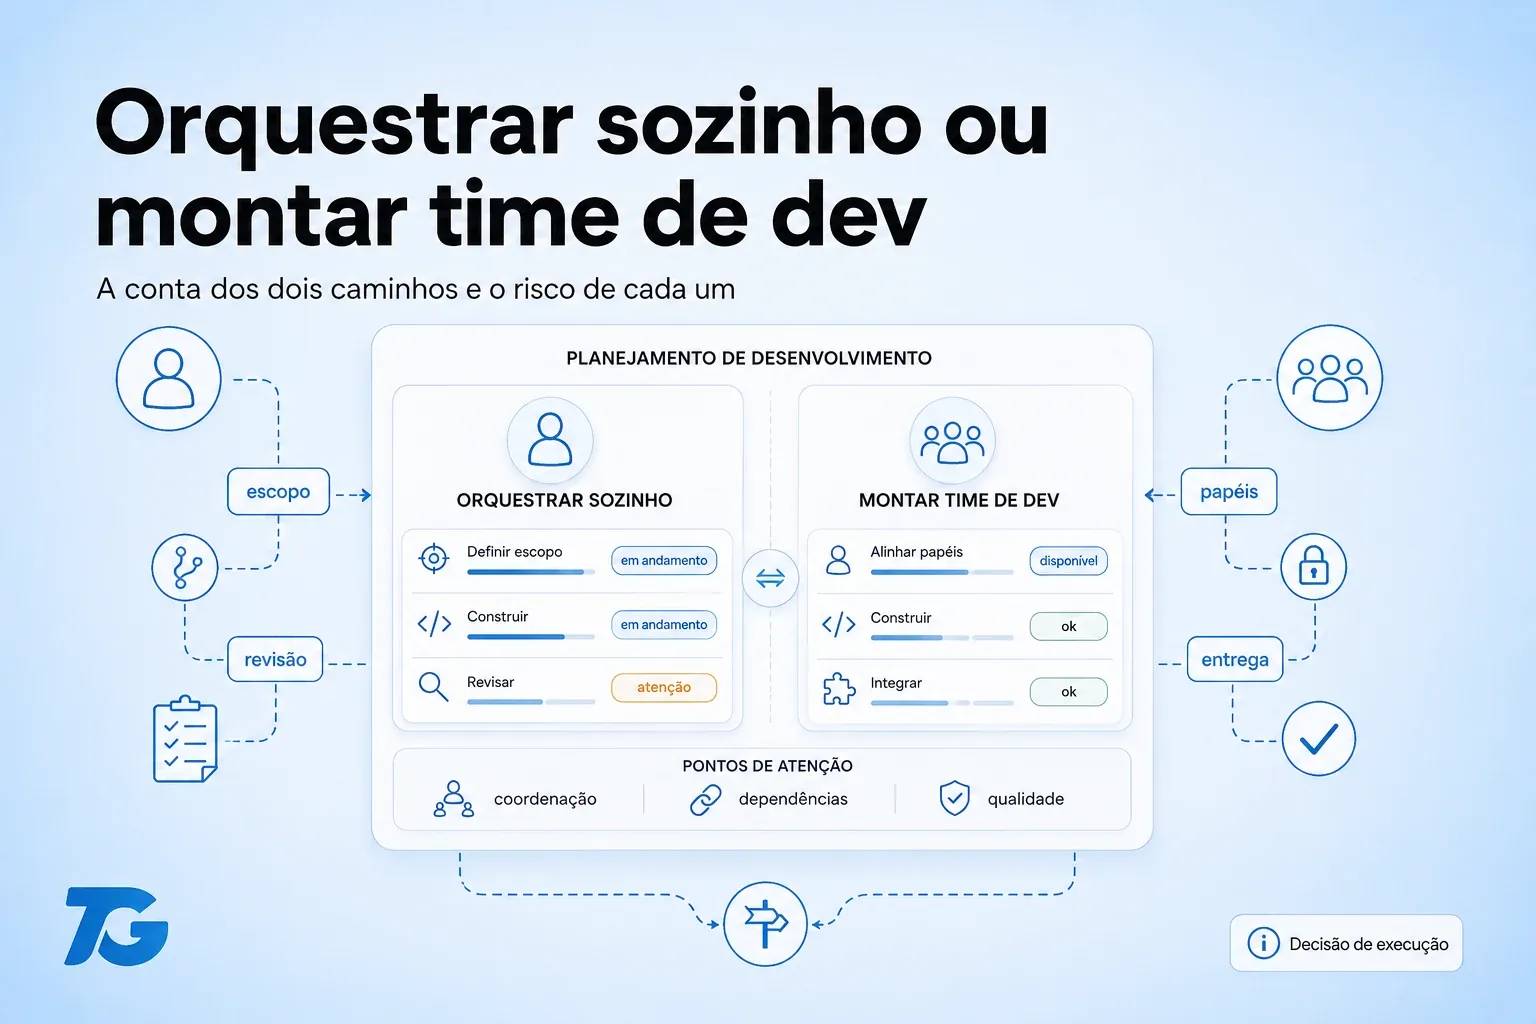
Qual a diferença prática entre orquestrar e vibe coding?
A diferença não está na ferramenta, porque os dois usam exatamente os mesmos agentes de código. Está em existir ou não um critério de aceite escrito antes de a primeira linha nascer. Vibe coding pergunta se funciona e aceita a demonstração como resposta. Orquestração pergunta se passa nos gates e aceita a evidência como resposta, o que é verificável por outra pessoa.
| Dimensão | Vibe coding | Orquestração |
|---|---|---|
| Ponto de partida | Pedido em linguagem solta | Documento de requisito e critério de aceite |
| Critério de pronto | A tela abriu | Gate automático passou |
| Revisão | Leitura do diff, quando acontece | Modelo oposto revisando, com veredito |
| Paralelismo | Um chat por vez | Raias isoladas, sem conflito de arquivo |
| Rastro | Fica no histórico do chat | Commit, teste e decisão registrados |
| Fonte: método aplicado nos meus projetos entregues, apurado em setembro de 2026. | ||
Vibe coding funciona muito bem para protótipo, para aprender e para validar uma ideia rápido. Ele quebra exatamente no ponto em que o projeto passa a ter usuário de verdade e dado que não pode sumir. A troca acontece quando o custo de um erro deixa de ser o seu tempo e passa a ser o prejuízo de outra pessoa. Reconhecer esse momento é a decisão mais importante de quem constrói com IA.
Quais são as quatro fases do método?
O processo é sempre o mesmo, independentemente do tamanho do projeto, e o que muda é quanto tempo cada fase leva. Num projeto de duas horas a especificação leva vinte minutos, e num projeto de trinta dias ela leva três dias. A ordem nunca muda, porque cada fase depende da anterior para fazer sentido. Pular a primeira é o que produz a maioria dos problemas que aparecem na quarta.
Fase 1, especificar: escrever o que o sistema faz, o que ele explicitamente não faz e como saber que ficou pronto, antes de qualquer código existir. O critério de aceite precisa ser verificável por alguém que não participou da conversa. Requisito que não dá para testar não é requisito, é intenção.
Fase 2, separar as raias: dividir o trabalho em frentes que não tocam os mesmos arquivos, para dois agentes rodarem em paralelo sem conflito. A separação boa é por fronteira de módulo, não por camada técnica. Dividir em frente e fundo garante conflito, porque quase toda tarefa atravessa as duas.
Fase 3, executar com gate: deixar o agente construir com teste, verificação de tipo e checagem de segurança rodando a cada passo. O gate precisa falhar de forma barulhenta e parar a construção, senão vira relatório que ninguém lê. Gate que avisa mas deixa passar não protege nada.
Fase 4, revisar cruzado: pedir a um modelo de família diferente que revise o trabalho do outro, com veredito fechado e evidência apontando arquivo e linha. Revisão sem veredito vira lista de sugestões e não decide nada. O revisor precisa dizer se aprova ou reprova, e por quê.
Por que usar dois modelos diferentes em vez de um?
Porque o mesmo modelo que escreveu um trecho tende a concordar com ele quando você pergunta se está certo. A pergunta soa como validação e recebe validação de volta, o que não é revisão nenhuma. Modelos de famílias diferentes foram treinados de formas diferentes e erram em lugares diferentes. É exatamente essa divergência que revela o defeito que nenhum dos dois acharia sozinho.
Na prática eu uso Claude Code e Codex no mesmo repositório, cada um numa cópia de trabalho isolada, e faço um revisar o trabalho do outro. Quando os dois concordam, a confiança no resultado é alta. Quando divergem, existe algo que merece atenção humana, e esse sinal é mais valioso que qualquer concordância. O arranjo técnico está em Git e worktrees com Claude Code e Codex, e a divisão de tarefas em Claude Code e Codex no mesmo fluxo.
Isso exige saber programar?
Exige saber julgar, o que não é a mesma coisa que saber digitar código de memória. É preciso entender arquitetura, reconhecer risco e saber o que significa um teste que passou. Quem tem essa base ganha muita velocidade, porque a parte mecânica sai da frente e sobra a parte de decidir. Quem não tem produz algo que funciona na demonstração e não consegue avaliar se aquilo aguenta produção.
Essa é a razão de orquestração acelerar muito quem já é desenvolvedor e frustrar quem esperava pular a etapa de aprender engenharia. O agente reduz o custo de escrever e não reduz o custo de entender. Para quem está começando, o caminho é usar o agente como professor e não como substituto, pedindo explicação de cada decisão. Aprender com ele é mais lento no começo e muito mais rápido no fim.
Onde esse método falha?
Ele falha quando o problema é de domínio e não de código, porque nenhum agente conhece a regra que só existe na cabeça de uma pessoa da empresa. Falha também quando a especificação está errada, já que o processo garante fidelidade ao pedido e não acerto do pedido. E falha em projeto com dependência externa mal documentada, onde o gargalo é o outro lado. Dizer isso importa, porque método vendido como infalível é sempre método mal entendido.
O ponto fraco mais comum na prática é o excesso de confiança depois de alguns sucessos seguidos. Passa a parecer desnecessário escrever critério de aceite para tarefa pequena, e aí a tarefa pequena quebra algo grande. Manter o processo mesmo quando ele parece burocrático é o que sustenta o resultado ao longo do tempo. Disciplina aqui vale mais que talento.
Por onde começar se você nunca fez isso?
Comece por um projeto pequeno e real, com critério de aceite escrito, e resista à vontade de pedir o sistema inteiro numa mensagem só. Um projeto que cabe em um fim de semana e termina de verdade ensina mais que um projeto grande abandonado no meio. Depois de três ou quatro ciclos completos, o processo deixa de parecer burocracia e passa a parecer óbvio. O ganho aparece quando a especificação vira o artefato principal e o código vira consequência dela.
O caminho completo, do documento inicial até o deploy, está descrito em como construir um SaaS com Claude Code e Codex. Para a parte de processo e de comandos, a documentação oficial do Claude Code cobre bem o funcionamento das ferramentas por baixo. Comece pelo projeto que você já queria fazer e ainda não fez, porque motivação real sustenta a curva de aprendizado.