Neste artigo
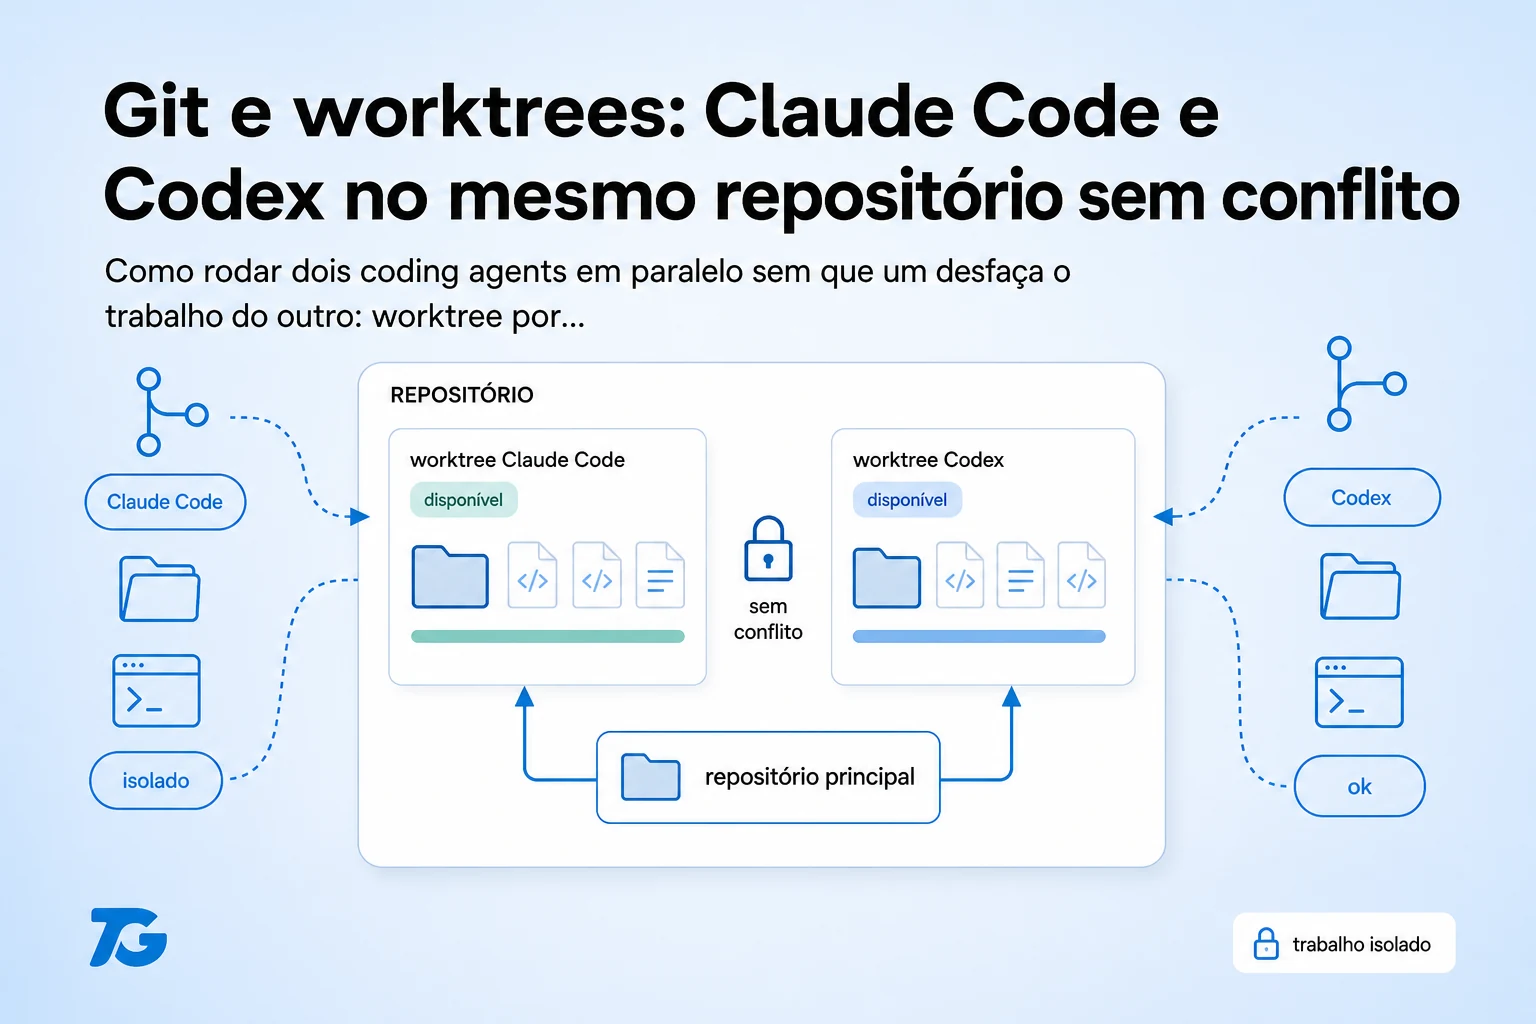
Dois agentes no mesmo repositório funcionam quando cada um trabalha numa worktree do Git separada, com escopo escrito e sem sobreposição de arquivos. O que quebra não é o Git, é a coordenação: quando os dois tocam a mesma área, você gasta mais tempo reconciliando do que teria gastado fazendo sozinho. Este post é a rotina que eu uso para rodar Claude Code e Codex em paralelo sem um desfazer o trabalho do outro.
Ele assume que você já roda pelo menos um agente com conforto. Se ainda não, a base está no guia completo de Claude Code em português, e a divisão de papéis entre os dois agentes está em Claude Code e Codex juntos. Aqui o assunto é só o repositório: como dois processos escrevem no mesmo histórico sem conflito, e quando nem vale a pena tentar.
Por que worktree e não branch normal?
Branch normal troca o conteúdo do mesmo diretório. Com dois agentes rodando, cada um com o seu processo e o seu servidor de desenvolvimento, eles brigam pelo mesmo espaço em disco: um faz checkout, o outro vê os arquivos mudarem no meio da tarefa. O git worktree resolve isso dando um diretório próprio para cada branch, compartilhando o mesmo repositório. Dois diretórios, dois agentes, um histórico só.
git worktree add ../proj-auth   feature/auth
git worktree add ../proj-billing feature/billing

# cada agente roda no seu diretorio, sem se ver
# quando terminar:
git worktree remove ../proj-auth
Cada agente é iniciado dentro da própria worktree, e o CLAUDE.md dele diz que ele só escreve ali. O stash é compartilhado entre worktrees, então a regra da casa é nunca usar stash solto com dois agentes vivos, porque um pode desempilhar a mudança do outro. Commit de trabalho em andamento resolve o mesmo problema sem esse risco. Parece detalhe, e é o tipo de coisa que só aparece quando já perdeu uma hora de trabalho.
Como dividir o trabalho para não dar conflito?
A divisão que funciona é por fronteira de módulo, não por tipo de tarefa. Dar "backend" para um e "frontend" para outro parece limpo e não é: os dois vão precisar mexer no contrato entre eles, e o contrato é um arquivo só. O que funciona é dividir por domínio vertical, cada um levando a fatia inteira. Um agente faz autenticação de ponta a ponta, o outro faz faturamento de ponta a ponta, e se tocarem num arquivo compartilhado, esse arquivo é meu, não deles.
| Divisão (medido em projetos próprios com os dois agentes até 15/09/2026, fonte: uso diário) | Funciona? | Por quê |
|---|---|---|
| Por domínio vertical | sim | fronteira natural, quase não colide |
| Backend x frontend | não | os 2 disputam o contrato da API |
| Um escreve, outro revisa | sim | sem escrita concorrente |
| Os dois na mesma feature | não | conflito garantido e retrabalho |
| Um no código, outro nos testes | depende | bom se a interface já estiver fechada |
O que precisa estar fechado antes de subir os dois?
Paralelismo só compensa se as decisões compartilhadas já estiverem tomadas. Se o schema ainda vai mudar, ou o padrão de erro da API não está definido, os dois vão inventar coisas diferentes e você junta duas versões incompatíveis. Antes de abrir a segunda worktree: schema estável, convenção de nomes escrita, padrão de resposta de erro definido e a fronteira entre os módulos explícita. É o mesmo material do arquivo de decisões de arquitetura, e é por isso que ele vem antes de qualquer paralelismo.
Por que concordância entre agentes não é validação?
Esse é o ponto que eu mais repito, porque é contraintuitivo e caro. Quando você pergunta a mesma coisa para Claude Code e Codex e os dois respondem igual, a sensação é de confirmação. Só que eles foram treinados em corpora que se sobrepõem bastante, e erram juntos nos mesmos lugares: as mesmas suposições sobre bibliotecas, os mesmos padrões de segurança esquecidos, a mesma leitura otimista de requisito ambíguo.
Já vi os dois concordarem que uma implementação de autorização estava correta quando ela deixava passar recurso de outro tenant. Concordância entre agentes é conforto, não prova. Prova é teste executado, de preferência o teste negativo, aquele que tenta acessar o que não devia e confirma que foi barrado. Quando os dois concordam e o teste negativo não existe, eu trato a concordância como um sinal para escrever o teste, não para fazer o merge.
Quando o segundo agente não vale a pena?
Na maior parte dos projetos pequenos, não vale. O segundo agente adiciona custo de assinatura, custo de coordenação e uma superfície nova de conflito, e só devolve valor quando existem frentes realmente independentes esperando na fila. A pergunta objetiva é esta: existem agora duas tarefas que não se tocam e que ambas estão prontas para começar? Se a resposta for não, um agente só entrega mais rápido, e o segundo é otimização de vazão antes de existir fila.
Que rotina de merge evita dor?
O que funciona para mim: cada worktree faz rebase da main pelo menos uma vez por dia, o merge acontece por frente inteira e não em pedaços, e eu leio o diff da fronteira entre os módulos mesmo quando não deu conflito. Conflito silencioso de semântica não aparece no Git: é quando os dois arquivos compilam juntos e a lógica ficou inconsistente, tipo um lado tratando valor em centavos e o outro em reais. Só a leitura da fronteira pega isso.
Quais são as dúvidas mais comuns?
Preciso das duas assinaturas? Só se tiver paralelismo real, e comece com uma. Dá para usar dois agentes do mesmo modelo? Dá, e para paralelismo puro funciona igual. Para revisão cruzada, modelos diferentes ajudam um pouco mais, porque os pontos cegos não coincidem tanto, mas continuam coincidindo o bastante para você não confiar cegamente. Como evito que um desfaça o trabalho do outro? Escopo escrito na tarefa, com a lista de arquivos que aquele agente pode tocar, e arquivo compartilhado sob a minha responsabilidade.
O processo inteiro em que isso se encaixa, do PRD ao deploy com os dois agentes, está em como construir um SaaS com Claude Code e Codex. Worktree é a parte mecânica; o que faz o paralelismo compensar é a especificação fechada antes e a leitura da fronteira depois. Sem essas duas pontas, dois agentes produzem retrabalho em dobro, com muito mais velocidade.