Neste artigo
- Por que a ordem importa mais do que a ferramenta?
- Etapa 1: o que entra no PRD antes de abrir o terminal?
- Etapa 2: quais decisões de arquitetura você não pode delegar?
- Etapa 3: como cuidar de banco e migrations quando quem escreve é um agente?
- Etapa 4: o que em autenticação e autorização eu nunca aceito sem ler?
- Etapa 5: como colocar dois agentes no mesmo repositório sem conflito?
- Etapa 6: como debugar código que você não escreveu?
- Etapa 7: o que testar primeiro quando o tempo é curto?
- Etapa 8: o que conferir de segurança e deploy antes do primeiro cliente pagante?
- Quanto disso dá para delegar ao agente?
- Você precisa saber programar para fazer isso?
- Quais são as dúvidas mais frequentes?
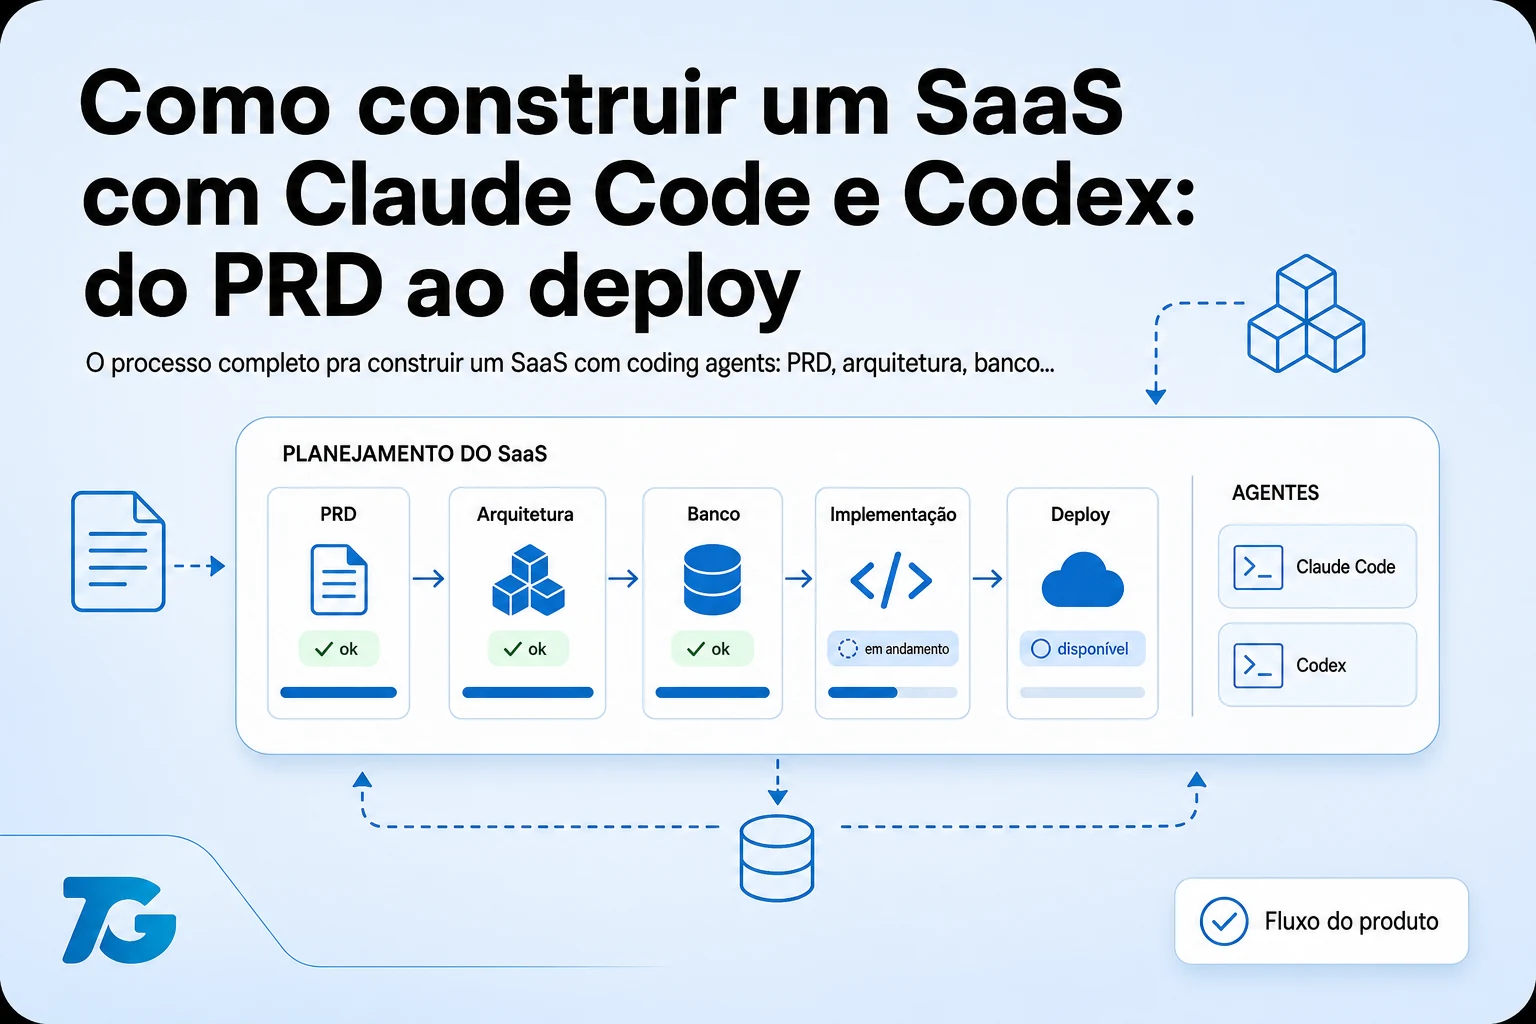
Construir um SaaS com Claude Code e Codex é um processo em oito etapas: PRD, arquitetura, banco, autenticação, implementação em raias paralelas, debug, testes e deploy. O agente escreve quase todo o código, e você decide o que é aceitável antes de ele escrever e revisa na mão os pontos onde errar custa caro. Este texto é o mapa, e cada etapa tem um guia próprio linkado no lugar certo.
A ordem importa mais do que a ferramenta. O mesmo processo funcionou com Claude Code sozinho, funciona hoje com os dois juntos e vai funcionar com o que vier depois. Se você ainda está instalando ou escolhendo plano, começa pelo guia completo de Claude Code em português e volta aqui quando a primeira tarefa simples já tiver rodado, porque este mapa assume que o agente já está na sua mão.
Por que a ordem importa mais do que a ferramenta?
O erro que eu mais vejo é começar pedindo código. A pessoa abre o terminal, descreve o produto em duas frases e manda gerar. Sai algo que roda na primeira tela e desmonta na terceira, porque nenhuma decisão de estrutura foi tomada antes, e o agente tomou todas sozinho, uma por vez, sem saber das outras. Coding agent é excelente em executar decisão tomada e péssimo em tomar decisão que depende de contexto que ninguém deu.
Quando eu especifico antes, o agente acerta quase tudo de primeira. Quando não especifico, ele inventa um padrão diferente em cada arquivo e eu gasto mais tempo reconciliando do que gastaria escrevendo. Então o método não é sobre prompt bonito, é sobre chegar na hora de gerar código com as perguntas difíceis já respondidas. As oito etapas abaixo são essas perguntas, na ordem em que elas precisam de resposta.
Etapa 1: o que entra no PRD antes de abrir o terminal?
O PRD define o que o sistema faz, para quem, e principalmente o que ele não faz. Não precisa ser documento de vinte páginas, precisa ser específico onde o agente erraria sozinho: quem são os papéis de usuário, o que cada papel pode ver e alterar, quais são as entidades principais e como se relacionam, e o que acontece nos casos ruins. Eu escrevo em markdown, dentro do repositório, versionado junto com o código, e quando a spec muda o commit conta a história. O formato com template está em spec-driven development do PRD ao merge.
Etapa 2: quais decisões de arquitetura você não pode delegar?
Existem escolhas baratas de fazer no começo e caríssimas de desfazer depois. Multi-tenancy é a principal: decidir se cada cliente tem schema próprio, banco próprio, ou se tudo divide as mesmas tabelas com uma coluna de tenant muda o modelo de dados e o custo de infraestrutura daí para frente. O agente vai escolher uma dessas se você não escolher, e vai escolher a mais simples de escrever, que quase nunca é a mais barata de manter. As cinco decisões que eu fecho antes estão em arquitetura de SaaS antes de gerar código.
Etapa 3: como cuidar de banco e migrations quando quem escreve é um agente?
Banco é onde o estrago fica. Código ruim você reescreve numa tarde, schema ruim com dado de cliente em cima você carrega por anos. O ponto que mais me deu trabalho foi drift de nomenclatura, com o ORM falando camelCase e o Postgres falando snake_case, e o agente escrevendo query crua que não bate com o mapeamento. A regra que eu adotei é simples: convenção de nomes escrita na spec, e migration sempre revisada por mim antes de rodar. Está tudo em banco de dados e migrations com agentes de IA.
Etapa 4: o que em autenticação e autorização eu nunca aceito sem ler?
Autenticação o agente costuma acertar, porque é padrão e tem biblioteca boa. Autorização ele erra, e erra de um jeito que passa em todos os testes felizes: o endpoint valida que você está logado e esquece de validar que aquele recurso é seu. Isso é IDOR, e num SaaS multi-tenant significa um cliente lendo o dado do outro. É o primeiro item que eu leio linha por linha, em todo projeto, sem exceção, e o jeito de revisar está em autenticação e autorização em SaaS multi-tenant gerado com IA.
Etapa 5: como colocar dois agentes no mesmo repositório sem conflito?
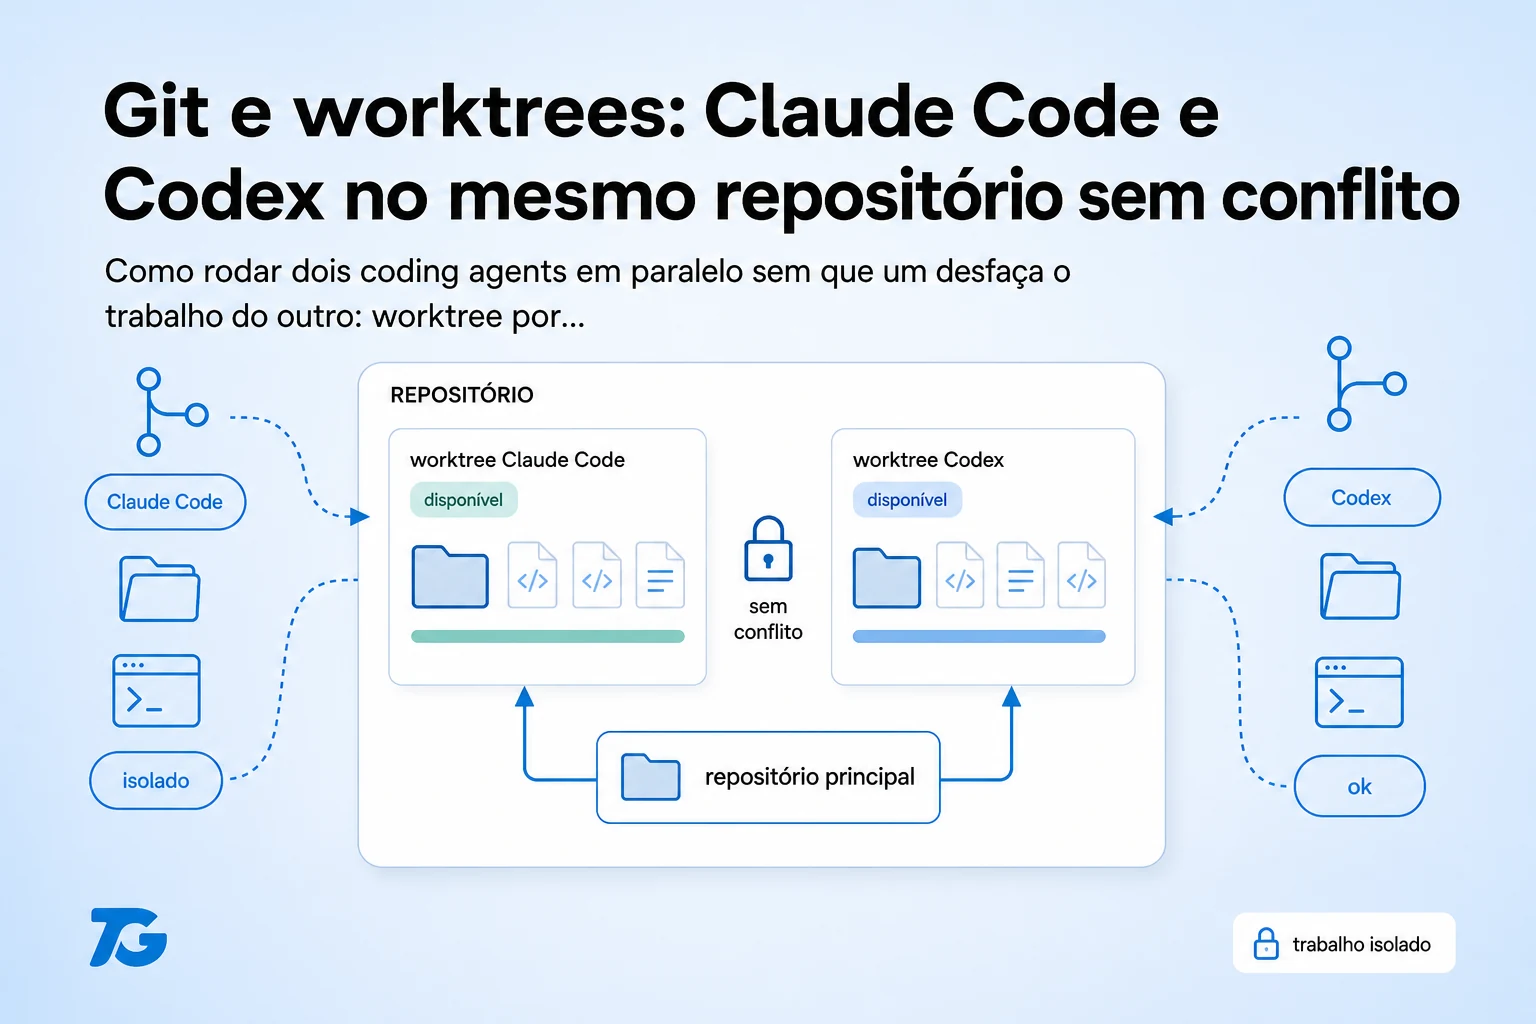
Quando o projeto tem frentes independentes, eu coloco Claude Code e Codex em paralelo, cada um na sua worktree do Git, cada um com escopo escrito. Frentes independentes de verdade, não duas pessoas no mesmo arquivo. Uma coisa que aprendi na marra: quando os dois chegam na mesma conclusão, isso não é validação, porque eles compartilham viés de treino e concordam errado com frequência. O setup está em Git e worktrees em paralelo, e a divisão de trabalho em Claude Code e Codex juntos.
Etapa 6: como debugar código que você não escreveu?
Em algum momento algo quebra e o código é do agente. O reflexo errado é colar o erro no chat e mandar consertar, porque aí ele tenta um remendo, o sintoma some, a causa fica e volta em outro lugar três dias depois. O que funciona é diagnosticar a raiz primeiro, na mão, e só então pedir a correção já sabendo qual é. O método completo, com os padrões de erro que se repetem em código gerado, está em como debugar código que a IA escreveu.
Etapa 7: o que testar primeiro quando o tempo é curto?
Cobertura total é conversa de quem não tem prazo. A ordem que eu uso é por consequência do erro: autorização, dinheiro, migração de dados, e só depois o resto. Se um desses três quebrar em produção, o problema não é técnico, é cliente ligando. O agente escreve os testes, e eu leio de verdade só os de autorização e pagamento, porque IA também escreve teste que passa fácil demais. Está detalhado em testes automatizados em projeto tocado por agente.
Etapa 8: o que conferir de segurança e deploy antes do primeiro cliente pagante?
Antes de subir, eu passo um checklist fixo, porque o agente tem pontos cegos previsíveis: segredo commitado, endpoint sem rate limit, upload sem validação de tipo, webhook sem verificação de assinatura, log gravando dado pessoal. São sempre os mesmos, e por isso viram lista, não memória. O checklist está em segurança antes de colocar um SaaS feito com IA em produção, e o caminho do container até o primeiro cliente em deploy de SaaS multi-tenant.
Quanto disso dá para delegar ao agente?
A tabela abaixo é a divisão que eu uso hoje, medida em projetos reais, e ela muda pouco de projeto para projeto. O que o agente decide sozinho é o que tem padrão consolidado e custo baixo de errar. O que eu decido é o que depende de contexto do negócio ou é caro de desfazer. E o que eu leio linha a linha é onde o erro vira cliente lendo o dado de outro cliente ou cobrança errada.
| Etapa (medido em projetos próprios até 15/09/2026, fonte: uso diário com Claude Code e Codex) | Quem decide | Quem escreve | Eu reviso linha a linha? |
|---|---|---|---|
| 1. PRD | você | você, com o agente achando buraco | não se aplica |
| 2. Arquitetura | você | você | não se aplica |
| 3. Schema e migrations | você | agente | sim, sempre |
| 4. Autorização | você | agente | sim, sempre |
| 5. CRUD e telas | agente | agente | não, revisão por amostragem |
| 7. Testes | você define a ordem | agente | só os de autorização e pagamento |
| 8. Deploy e infra | você | agente | sim, na primeira vez |
Você precisa saber programar para fazer isso?
Precisa saber ler código o suficiente para discordar do agente. Não precisa começar sabendo, e boa parte de quem faz a travessia comigo veio de WordPress, de n8n ou de tráfego, sem base formal. Só que a ideia de que dá para construir SaaS em produção sem nunca entender o que está escrito é falsa, e quem vende isso te deixa na mão no dia em que der problema. O que muda com método é a curva: você aprende a ler o que importa primeiro, em vez de tentar aprender tudo antes de começar.
Quais são as dúvidas mais frequentes?
Dá para usar só Claude Code, sem Codex? Dá, e é o que eu recomendo para começar. O segundo agente resolve paralelismo, não qualidade, e sem frentes independentes ele só adiciona custo e coordenação. Quanto tempo leva do PRD ao primeiro deploy? Um SaaS pequeno de verdade, com domínio bem definido, sai em dias. O que estica o prazo quase nunca é a geração de código, é decisão em aberto: escopo que muda no meio, integração de terceiro imprevista, regra de negócio que ninguém escreveu.
E quando o agente insiste num caminho ruim? Isso costuma ser sintoma de spec vaga, não de teimosia. Antes de brigar no chat, eu volto na spec e escrevo explicitamente o que não pode, e funciona melhor do que repetir a instrução em maiúsculas. A documentação de memória do Claude Code explica onde essa instrução mora para valer em toda sessão, e é ali que a spec vira comportamento.