Neste artigo
Quando o agente escreve as migrations, três coisas mudam: a convenção de nomes precisa estar escrita antes, toda migration destrutiva vira revisão manual obrigatória, e o rollback tem que existir antes de rodar em produção. Código ruim se reescreve numa tarde. Schema ruim com dado de cliente em cima você carrega por anos.
Por que o drift de nomenclatura custa tanto tempo?
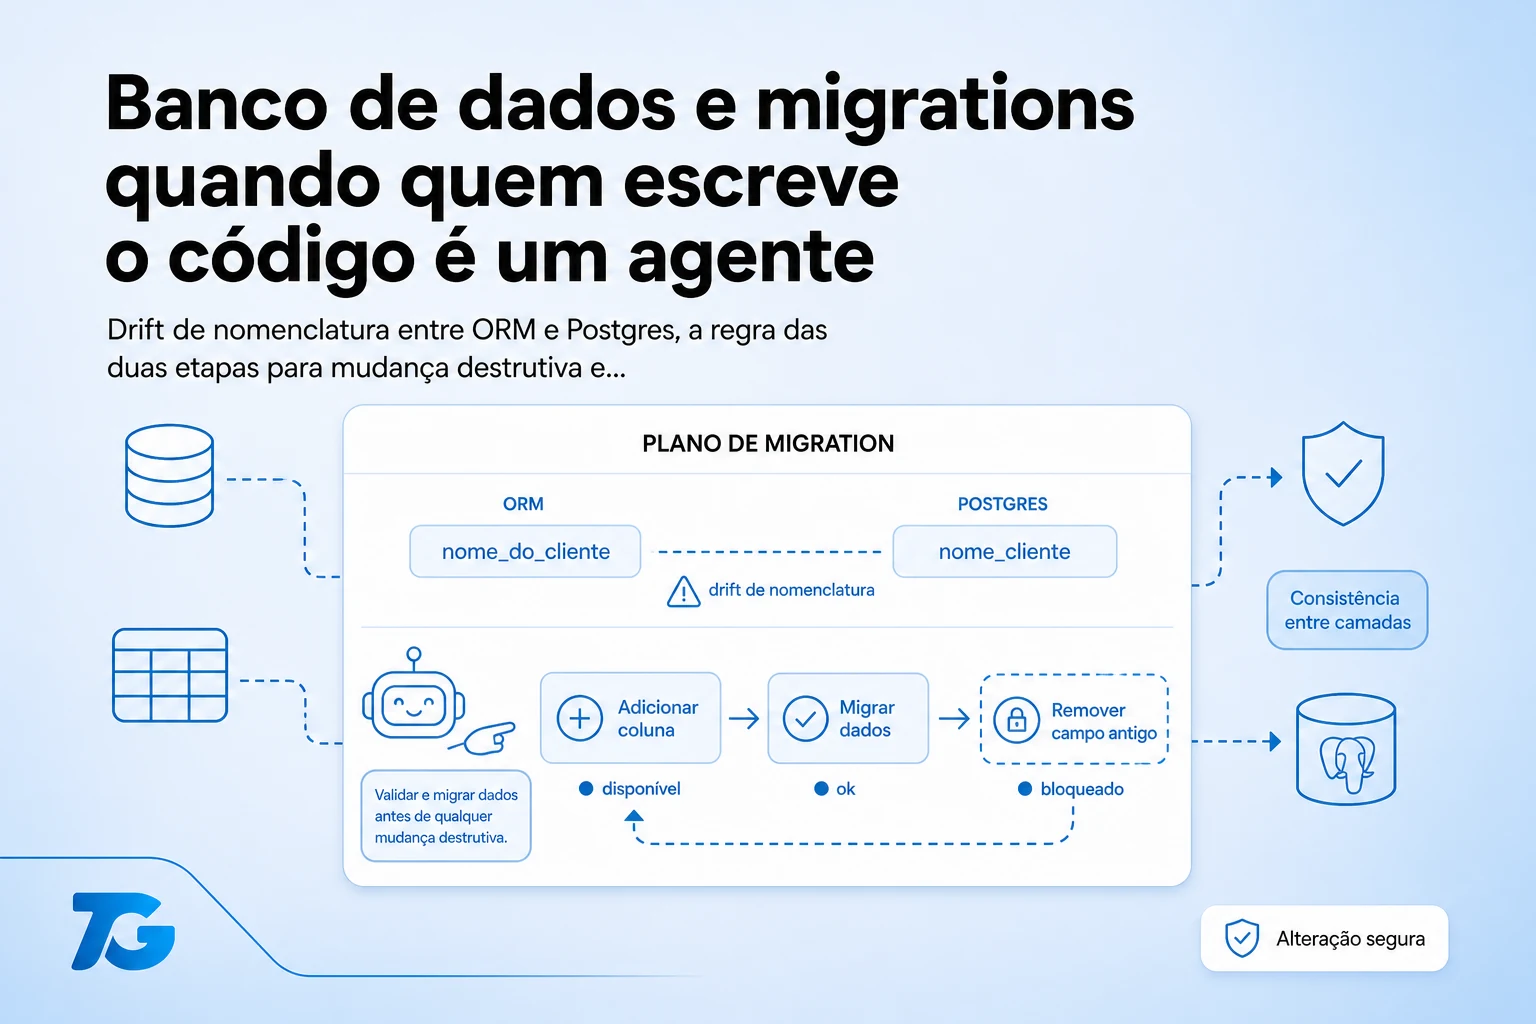
O ORM fala uma língua e o Postgres fala outra. Prisma e TypeORM trabalham em camelCase, o Postgres é feliz em snake_case, e existe um mapeamento no meio. Enquanto todo acesso passa pelo ORM, ninguém percebe.
O problema aparece na primeira query crua. O agente escreve um relatório com SQL na mão, usa createdAt porque foi isso que ele viu no modelo, e o Postgres responde que a coluna não existe, ou pior, encontra uma coluna parecida e devolve dado errado sem erro nenhum.
A correção é chata e definitiva: escolher uma convenção, escrever no arquivo de decisões, e nunca mais discutir.
# Convencao de nomes (nao reabrir)

- Postgres: snake_case, tabela no plural (users, project_members)
- Prisma: camelCase no modelo, @map explicito pra toda coluna
- Query crua: SEMPRE snake_case, sempre com o nome real da coluna
- Boolean: prefixo is_ ou has_ (is_active, has_billing)
- Timestamp: created_at, updated_at, deleted_at
Por que a migration é o ponto de revisão?
Eu deixo o agente escrever quase tudo sem ler linha por linha. Migration não entra nessa lista, por um motivo simples: é a única categoria de mudança onde o erro não é reversível por deploy.
Se um endpoint sai errado, você corrige e sobe de novo. Se uma migration apagou uma coluna com dado, o deploy seguinte não traz o dado de volta.
O que eu procuro na leitura, sempre nessa ordem:
| O que | Por que importa | O que eu faço |
|---|---|---|
DROP COLUMN ou DROP TABLE |
Perda de dado sem volta | Só aprovo em duas etapas: para de usar, depois remove |
| Mudança de tipo em coluna com dado | Pode truncar em silêncio | Exijo migration de cópia, nunca conversão direta |
NOT NULL em tabela populada |
Quebra na hora se houver nulo | Default primeiro, backfill depois, constraint por último |
| Índice novo em tabela grande | Trava escrita durante a criação | Criação concorrente |
| Renomear coluna | Quebra o código antigo durante o deploy | Adiciona a nova, migra, remove depois |
Como fazer mudança destrutiva sem risco?
Quase toda mudança perigosa de schema fica segura se você quebrar em duas migrations separadas por um deploy.
Remover uma coluna vira: primeiro um deploy onde o código para de ler e escrever nela, com a coluna ainda lá; depois, num deploy seguinte, a migration que remove. Entre os dois você tem uma janela onde dá pra voltar atrás sem perder nada.
O agente não faz isso sozinho porque a instrução “remova a coluna X” tem uma implementação óbvia de uma etapa. Quando eu escrevo na spec que mudança destrutiva é sempre em duas etapas, ele passa a fazer certo.
Como tratar seed e dado de teste?
Um detalhe pequeno que evita retrabalho: peça o seed junto com a migration. Sem dado de exemplo, você só descobre que o schema está estranho quando a tela já foi construída em cima dele.
Eu peço seed com pelo menos dois tenants diferentes, sempre. É a forma mais barata de fazer aparecer um vazamento de isolamento entre clientes ainda no ambiente local, em vez de em produção. Mais sobre isso em autenticação e autorização em SaaS multi-tenant.
Como pedir a migration para o agente?
A diferença entre um pedido que dá certo e um que dá trabalho está no que você fecha antes:
Adicione a tabela invoices.

Restricoes:
- snake_case, plural, created_at/updated_at obrigatorios
- tenant_id NOT NULL com FK e indice
- valor em inteiro de centavos, nunca float
- status em enum: draft, open, paid, void
- migration reversivel, com down implementado
- seed com 2 tenants e 3 invoices cada, status diferentes
“Valor em inteiro de centavos, nunca float” é o tipo de linha que parece pedante e economiza um bug de arredondamento em dinheiro que só aparece na conciliação do primeiro mês.
Perguntas frequentes
Posso deixar o agente rodar a migration sozinho?
Em ambiente local, sim, e é até bom, porque ele descobre o erro na hora. Em produção, não. A migration de produção é passo manual no meu fluxo, mesmo quando o deploy é automatizado.
E se o schema já nasceu torto?
Corrige por partes, com a regra das duas etapas, começando pelo que trava mais. Reescrever schema inteiro de uma vez, com dado em cima, é o tipo de operação que estraga o fim de semana.
ORM ou SQL cru?
ORM pro CRUD, SQL cru pro que o ORM faz mal, que costuma ser relatório e agregação. O que não pode é ter os dois com convenções diferentes. Contexto completo em como construir um SaaS com Claude Code e Codex.