Neste artigo
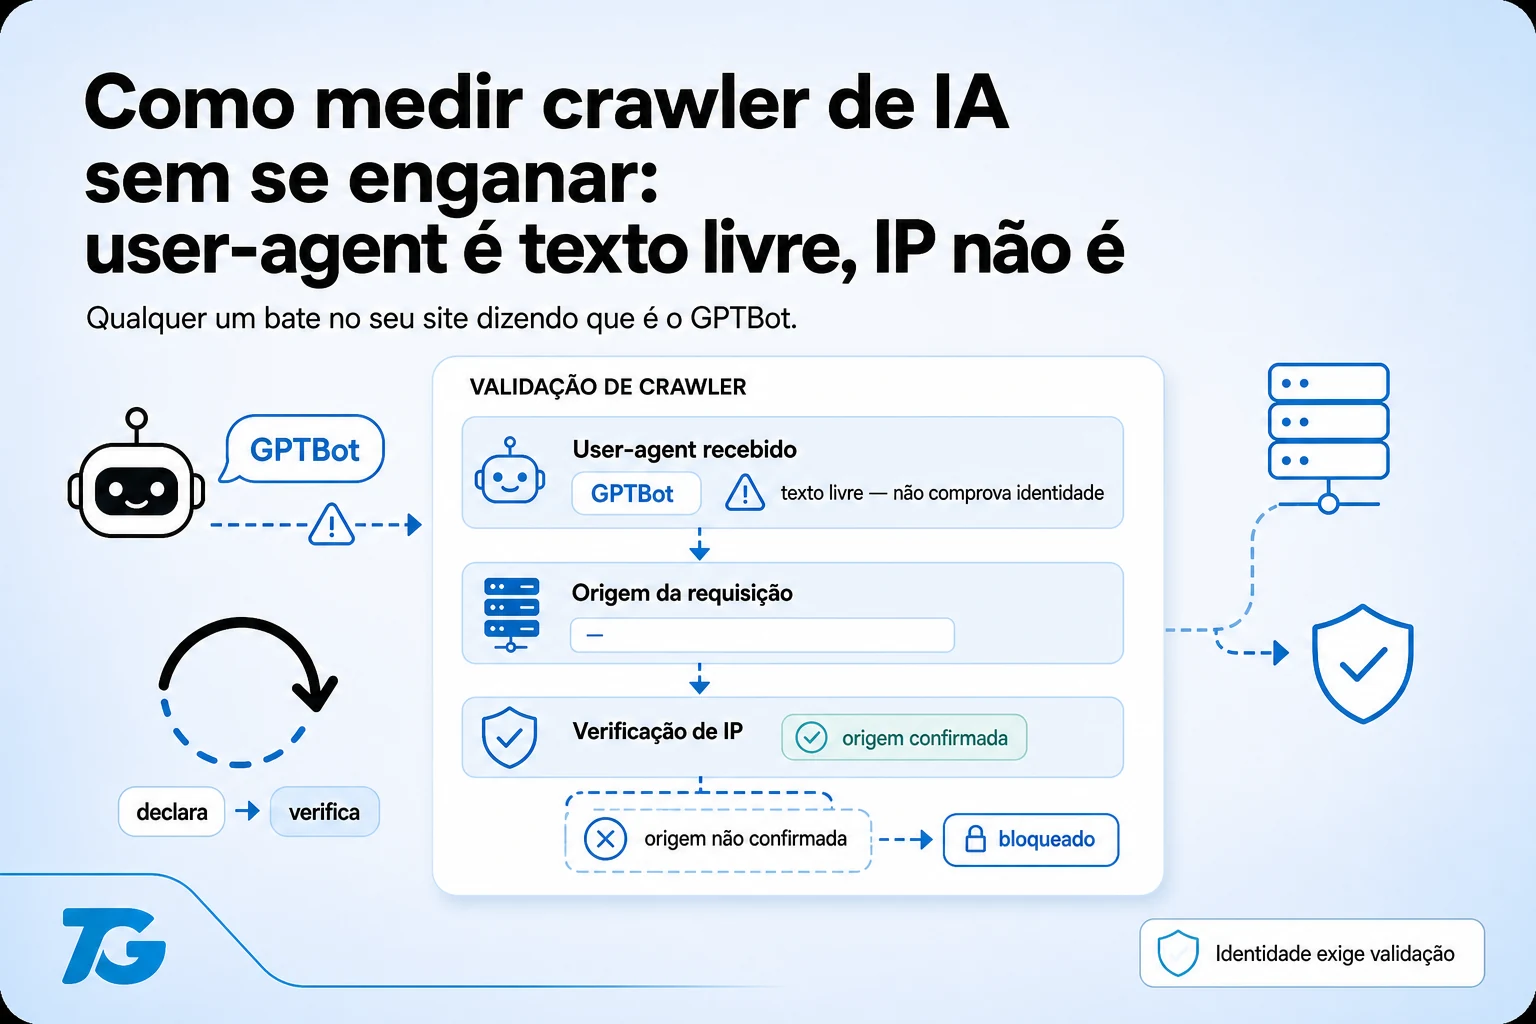
Contar visita de robô pelo user-agent não mede nada, porque user-agent é texto livre que qualquer um escreve. Eu consigo bater no seu site agora dizendo que sou o GPTBot, e o seu log vai registrar uma visita do GPTBot. A medição que resiste usa classificação por IP: na Cloudflare, o campo verifiedBotCategory; na OpenAI, as faixas publicadas em openai.com/searchbot.json.
A diferença aparece na hora em que alguém decide se o investimento em conteúdo está funcionando.
Como a Cloudflare classifica?
Ela mantém uma lista de bots verificados e confere a origem da requisição contra os blocos de IP declarados pela empresa dona do robô. Requisição que se diz GPTBot mas vem de um IP residencial simplesmente não recebe a categoria.
A consulta sai pela Analytics GraphQL:
query {
  viewer {
    zones(filter: { zoneTag: "SEU_ZONE_ID" }) {
      httpRequestsAdaptiveGroups(
        limit: 500
        filter: {
          date_geq: "2026-08-13", date_leq: "2026-08-20",
          verifiedBotCategory: "AI Crawler"
        }
        orderBy: [date_DESC]
      ) {
        count
        dimensions { date userAgent clientRequestPath }
      }
    }
  }
}
Precisa de um token com permissão Zone Analytics: Read. Duas limitações que valem saber antes de montar painel em cima disso:
A retenção é curta. No plano gratuito são pouco mais de 7 dias. Pedir 30 dias devolve erro de quota e derruba a consulta inteira. Se você quer série histórica, precisa guardar o resultado por conta própria.
O user-agent vem inteiro. Você recebe a string completa, então precisa normalizar para o nome do robô antes de agregar, senão o mesmo bot aparece em várias linhas por causa de versão.
Como conferir contra as faixas da OpenAI?
A OpenAI publica os prefixos de IP de cada robô em três arquivos: openai.com/searchbot.json, gptbot.json e chatgpt-user.json. Cruzar a categoria da Cloudflare com esses prefixos dá uma segunda confirmação independente.
Eu testei o método contra ele mesmo: mandei uma requisição forjada com User-Agent: OAI-SearchBot/1.0 do meu próprio IP. Ela apareceu no log bruto e não apareceu na consulta filtrada por categoria verificada. É o comportamento que se espera de uma medição que serve para decidir alguma coisa.
Qual robô devo acompanhar?
Não é o que a maioria das listas diz. A resposta prática, por ordem de utilidade:
| Robô | O que significa quando aparece |
|---|---|
| ChatGPT-User | Alguém perguntou algo e o modelo abriu a sua página. É o sinal mais forte: página aberta é citada em 74% das vezes. |
| OAI-SearchBot | Rastreio de busca. Pode passar meses sem aparecer sem que isso signifique nada de ruim. |
| GPTBot | Rastreio de treino. A OpenAI reaproveita um único rastreio para os dois usos quando ambos estão liberados. |
| PerplexityBot | Rastreio do Perplexity, historicamente o primeiro a achar site novo. |
| ClaudeBot | Rastreio da Anthropic. |
Por que a ausência do OAI-SearchBot não é problema?
Porque a documentação da OpenAI diz que um rastreio pode servir aos dois bots, e porque páginas canário com log completo pegaram esse robô quase mudo enquanto o índice continuava servindo aquelas URLs em respostas.
Nos meus dois domínios, o OAI-SearchBot não apareceu nenhuma vez em oito dias. As páginas estavam no índice do ChatGPT o tempo todo, e eu confirmei isso com um teste direto de índice.
Se você montar um critério de aceite em cima da presença desse robô, vai declarar fracasso num site que está funcionando.
E o utm_source=chatgpt.com?
Ele mede clique de saída, não leitura. E tem um buraco importante: as páginas que o modelo abre sozinho no modo thinking, justamente as com 74% de taxa de citação, não carregam UTM nenhum.
Filtrar seu analytics por esse parâmetro conta os cliques e perde as leituras. Use como métrica de tráfego, nunca como métrica de exposição.
O painel mínimo que eu recomendo
Três números, atualizados semanalmente:
- Hits de crawler de IA verificado, por robô, na janela que a Cloudflare permite.
- URLs distintas de artigo lidas por IA. Cobertura importa mais que volume: 200 hits em uma página só é pior que 40 hits em 40 páginas.
- Quantas URLs estão no índice da OpenAI, pelo teste direto, medido mensalmente.
Sessão de canal “AI Assistant” no GA4 entra como quarto número, com a ressalva de que ele subconta: clique vindo de IA sem referrer cai em Direct. Trate como piso, nunca como total.
Perguntas frequentes
Dá para fazer sem Cloudflare?
Dá, com log bruto do servidor mais conferência de IP reverso contra as faixas publicadas. Dá mais trabalho e o resultado é o mesmo. O que não serve é confiar no user-agent puro.
Quanto tempo até ver movimento depois de liberar os robôs?
A OpenAI documenta cerca de 24 horas para os sistemas dela ajustarem depois de mudança no robots.txt. O rastreio em si depende de demanda, então pode demorar bem mais. Antes de esperar, confirme que você não está bloqueando sem saber: a CDN pode estar antepondo um Disallow ao seu arquivo.
Bloquear robô de treino prejudica a busca?
Na prática, sim. Como a OpenAI reaproveita um rastreio para os dois usos, bloquear o de treino reduz o volume total de leitura do seu site, mesmo com o de busca liberado.