Neste artigo
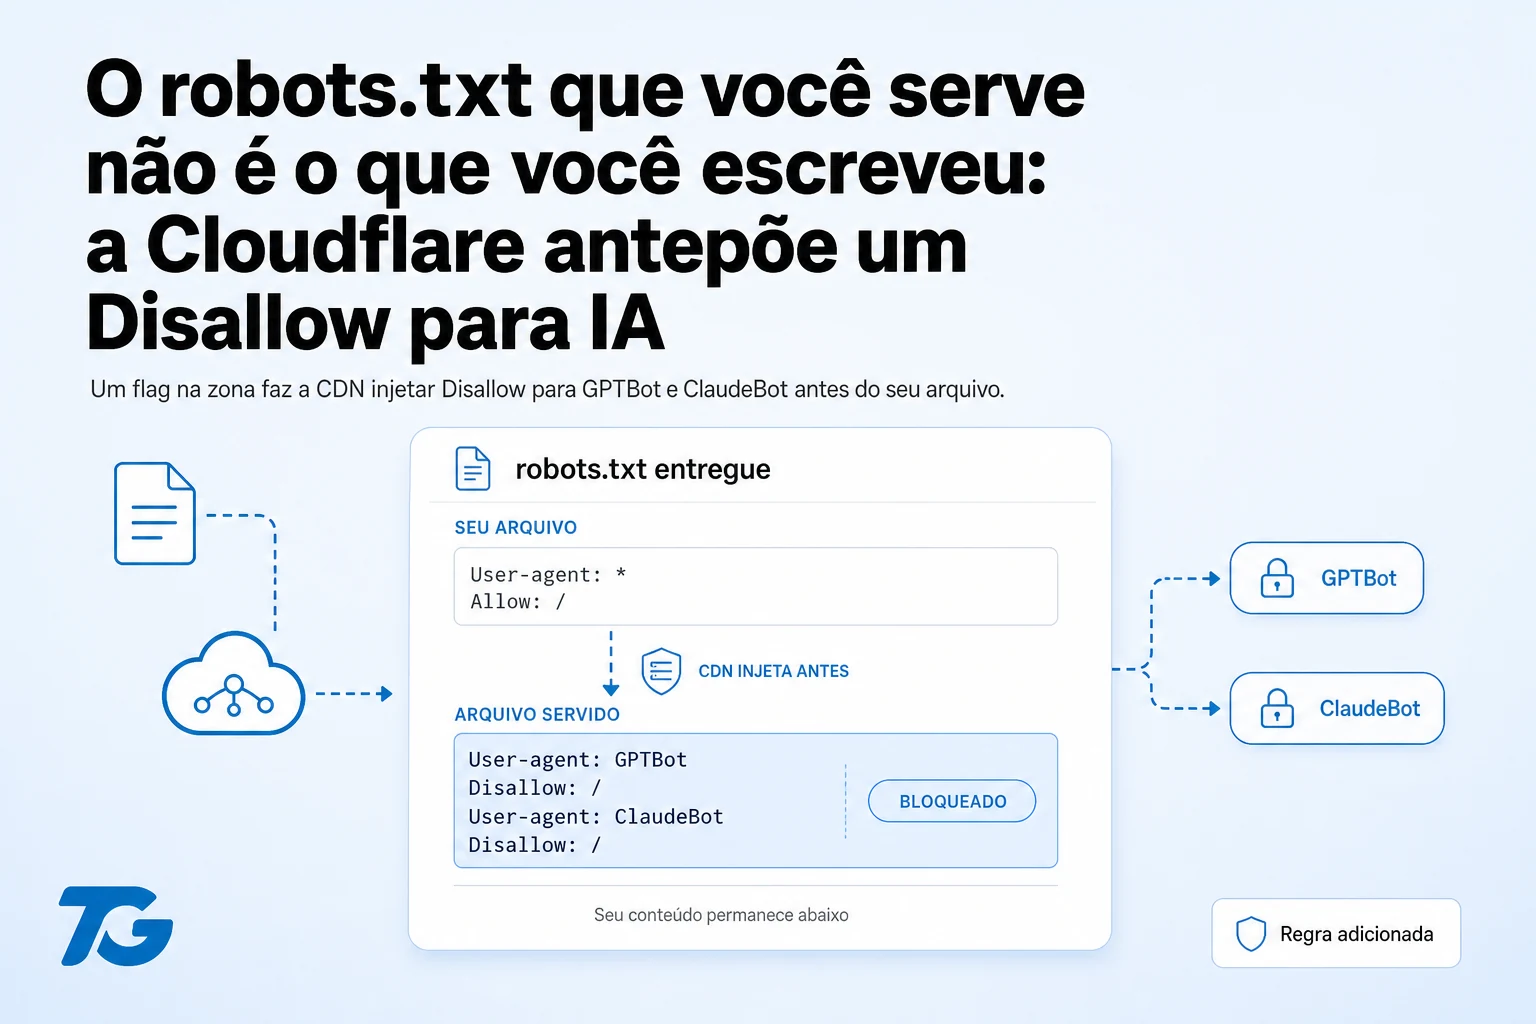
O robots.txt que o seu domínio entrega pode não ser o arquivo que está no seu repositório, e isso começa em Cloudflare o que é: uma camada que fica na frente do seu servidor e responde antes dele. A Cloudflare tem um recurso chamado managed robots.txt que antepõe um bloco ao seu arquivo, e esse bloco manda GPTBot, ClaudeBot, CCBot e Google-Extended embora. Seu arquivo pode dizer Allow: / logo abaixo, e o Disallow chega primeiro.
Descobri isso em produção depois de semanas achando que o problema era conteúdo. O efeito estava medido no meu próprio log e eu não tinha ligado os pontos.
Qual foi o efeito real?
Dois domínios meus, mesma stack, mesma janela de 7 dias, mesmo tipo de conteúdo. A diferença era só esse flag na zona da Cloudflare:
| Domínio | robots.txt | Hits do GPTBot em 7 dias |
|---|---|---|
| thalesgomes.com | limpo | 36 |
| syntaxlab.com.br | com bloco da Cloudflare | 1 |
| Fonte: medição no log próprio, em agosto de 2026. | ||
Não é margem de erro. É um site sendo lido e outro não.
Como o bloco aparece no arquivo?
A documentação da Cloudflare é explícita sobre o mecanismo: se o seu servidor já tem um robots.txt respondendo 200, a Cloudflare prepends our managed robots.txt before your existing robots.txt, combining both into a single response. O resultado servido fica assim:
# BEGIN Cloudflare Managed content
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
# END Cloudflare Managed Content

# ...e so entao o SEU arquivo, dizendo Allow: /
Repare no Content-Signal: ai-train=no. Além do bloqueio, ele publica uma declaração de política em nome do site, que pode ou não ser o que você quer dizer.
Por que ninguém percebe?
Porque a auditoria de SEO padrão olha o arquivo no repositório, ou abre o robots.txt uma vez, quando o site sobe, e nunca mais. O flag da Cloudflare pode ser ligado depois, por outra pessoa, ou por padrão numa configuração nova de zona.
E porque o sintoma é ambíguo. O site não cai, não dá erro, não some do Google. Ele só para de ser lido por uma parte dos robôs, o que você só vê olhando log de crawler.
Onde eu vejo se está ligado?
No painel: Security → Settings, filtro Bot traffic, opção Set your preference to block training in robots.txt.
Pela API, o campo é is_robots_txt_managed:
curl "https://api.cloudflare.com/client/v4/zones/$ZONE/bot_management" \
  -H "Authorization: Bearer $CF_TOKEN"
Para desligar:
curl -X PUT "https://api.cloudflare.com/client/v4/zones/$ZONE/bot_management" \
  -H "Authorization: Bearer $CF_TOKEN" \
  -H "Content-Type: application/json" \
  --data '{"is_robots_txt_managed":false}'
A mudança vale na hora. Confira com curl https://seudominio/robots.txt.
Devo desligar sempre?
Não. É decisão de negócio, e o recurso existe porque muita gente quer exatamente isso.
O que não pode é ter os dois. Se o seu robots.txt diz Allow para GPTBot porque você quer aparecer em resposta de IA, e a Cloudflare diz Disallow na frente, você tem uma contradição publicada em nome do seu domínio, e quem decide é o bloco que vem primeiro.
Vale lembrar a distinção que o próprio arquivo apaga: GPTBot é rastreio de treino, OAI-SearchBot é rastreio de busca. Bloquear o segundo é sumir do ChatGPT Search. E como a OpenAI reaproveita um único rastreio para os dois quando ambos estão liberados, bloquear o de treino também reduz o de busca na prática.
Qual é a regra que sobra disso?
Nunca audite robots.txt pelo arquivo do repositório. Audite sempre com curl no domínio de produção, e refaça isso depois de qualquer mudança de CDN, de plano ou de plugin.
Vale para Cloudflare, para plugin de SEO em WordPress, para proxy reverso e para qualquer serviço que ofereça “proteção contra IA” como caixinha de marcar.
O que mais perguntam sobre isso?
Isso afeta o Google normal?
O bloco atinge Google-Extended, que é o controle de treino de IA do Google, não o Googlebot. Seu ranqueamento orgânico não muda. O que muda é a elegibilidade para AI Overviews e Gemini.
Como confiro se voltou a ser lido?
Log de crawler verificado, não user-agent. A Cloudflare classifica por IP com verifiedBotCategory, então requisição forjada não conta. Explico o método em como medir crawler de IA sem se enganar. Para saber se a página entrou no índice, o teste direto está aqui.
Quanto tempo até o robô voltar?
A OpenAI documenta que leva cerca de 24 horas para os sistemas de busca dela ajustarem depois de uma mudança no robots.txt. O rastreio em si depende de demanda, então não espere retomada imediata.