Neste artigo
- O que é spec-driven development na prática, sem o jargão?
- Quais artefatos o projeto precisa ter no disco, e para que serve cada um?
- Qual é a diferença entre AGENTS.md e CLAUDE.md, e por que ter os dois?
- Qual é a ordem das fases, e por que pular uma custa caro?
- Como quebrar epic em tasks atômicas com acceptance criteria?
- Como manter Claude Code e Codex no mesmo repositório sem conflito?
- Que quality gates rodar antes de aceitar o diff do agente?
- O que é context engineering, e por que ele importa mais que o prompt?
- Quando essa disciplina toda é exagero?
- Por onde começar amanhã?
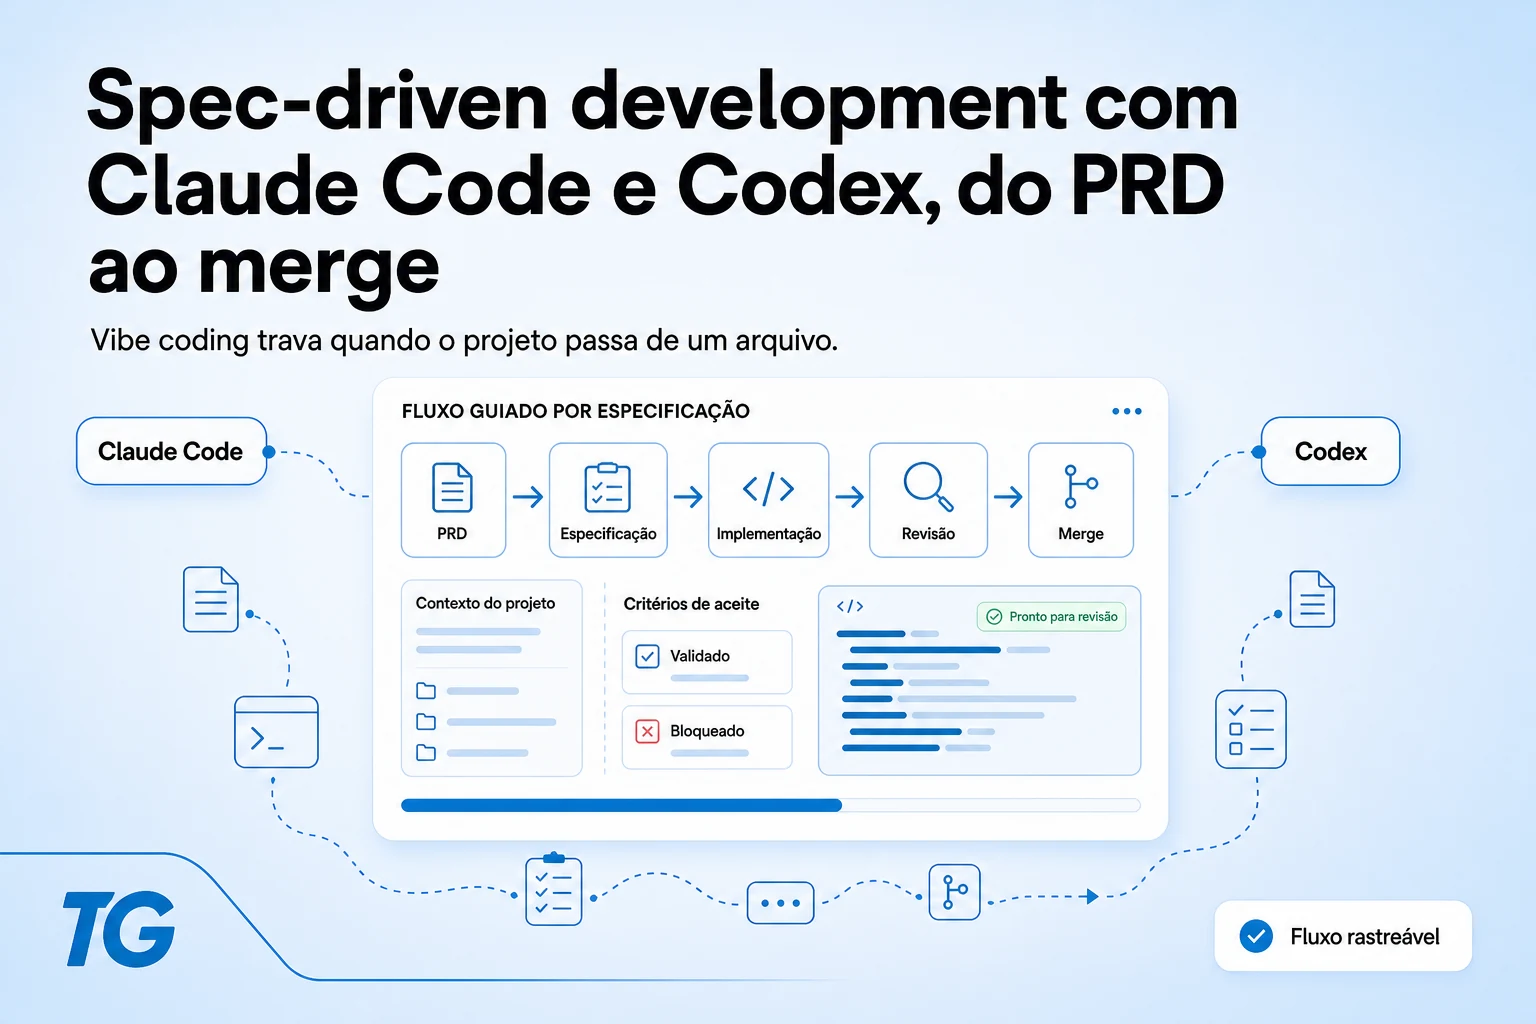
Spec-driven development é parar de conversar com o agente e começar a dar documento para ele: PRD, arquitetura, decisões e tarefas atômicas versionadas no repositório, em vez de decisão vivendo no histórico do chat. É o que destrava o projeto quando ele passa do tamanho que cabe numa conversa. Este é o processo que eu uso todo dia com Claude Code e Codex, do PRD até o merge.
Tem um ponto em todo projeto tocado com IA onde a coisa vira. Nos primeiros dias você pede, o agente entrega, e parece mágica. Aí o projeto chega no quinto ou sexto arquivo e o agente refaz o que já estava pronto, esquece a decisão de ontem e inventa estrutura nova toda sessão. A sensação é de que ele ficou burro, e não ficou: o projeto passou do tamanho da conversa. Vibe coding é uma fase, serve para descobrir o que construir e serve mal para construir. A base de tudo isso, do CLAUDE.md ao limite do plano, está no guia completo de Claude Code em português.
O que é spec-driven development na prática, sem o jargão?
A diferença aparece no segundo dia. No vibe coding, você abre uma sessão nova e o agente não sabe nada, então você reexplica, e ele reconstrói o entendimento de um jeito ligeiramente diferente do de ontem. No spec-driven, você abre a sessão, ele lê os arquivos e continua de onde parou. O contexto não mora na conversa, mora no projeto. E tem um efeito colateral que eu não esperava: os documentos ficam bons para mim também. Quando volto num projeto depois de três semanas, leio o PRD e o DECISIONS.md antes de olhar código, como o agente faz.
Quais artefatos o projeto precisa ter no disco, e para que serve cada um?
Esta é a estrutura a que eu chego hoje, depois de errar bastante para chegar nela. Não é a única que funciona, é a que sobreviveu ao uso. Cada arquivo responde a uma pergunta que, sem ele, o agente responde sozinho e diferente a cada sessão. A tabela depois da árvore diz o que cada um resolve e o que acontece quando ele falta.
/docs
├── PRD.md              o que estamos construindo e por que
├── ARCHITECTURE.md     como as peças se encaixam
├── DATABASE.md         schema, relações, migrations
├── API.md              contratos de entrada e saída
├── SECURITY.md         o que é sensível e como é tratado
├── DECISIONS.md        o que já foi decidido e o que foi descartado
└── features/
    └── autenticacao/
        ├── SPEC.md       o comportamento esperado dessa feature
        ├── TASKS.md      as tasks atômicas pra chegar lá
        └── TEST-PLAN.md  como saber que ficou pronto
AGENTS.md               como o agente deve trabalhar neste repo
CLAUDE.md o mesmo, na convenção do Claude Code| Arquivo (estrutura medida em projetos próprios até 15/09/2026, fonte: uso diário com Claude Code e Codex) | Responde | Sem ele, o agente |
|---|---|---|
| PRD.md | o quê e por quê | otimiza para elegância técnica em vez de para o problema do usuário |
| ARCHITECTURE.md | onde as coisas moram | cria uma pasta nova toda vez que precisa de lugar para um arquivo |
| DECISIONS.md | o que foi decidido e o que foi descartado | propõe de novo, a cada 2 semanas, a abordagem que vocês já rejeitaram |
| SPEC.md, TASKS.md, TEST-PLAN.md por feature | o comportamento, as tarefas e o critério de pronto de 1 feature | carrega o projeto inteiro para fazer uma coisa pequena |
| AGENTS.md e CLAUDE.md | como trabalhar neste repositório | inventa convenção, e um dos 2 agentes trabalha cego |
O DECISIONS.md é o mais subestimado da lista, porque guarda o que foi descartado e por quê. Sem isso você revive a mesma discussão a cada duas semanas. E SPEC, TASKS e TEST-PLAN ficam por feature, não na raiz, de propósito: o agente que mexe em autenticação lê a pasta de autenticação e não carrega o projeto inteiro para fazer uma coisa pequena. É contexto curado por desenho, não por disciplina na hora do pedido.
Qual é a diferença entre AGENTS.md e CLAUDE.md, e por que ter os dois?
São a mesma ideia com dois nomes, e isso é bobo, mas é a realidade hoje. O Claude Code lê o CLAUDE.md, o Codex lê o AGENTS.md, e se você só tem um dos dois, um dos agentes trabalha cego. Eu mantenho os dois com o mesmo conteúdo essencial e uma seção específica em cada. O tronco comum é a stack, como rodar os testes, a convenção de nome e o que nunca fazer neste repositório. A parte específica é o que cada ferramenta faz melhor.
Um detalhe que economiza dor de cabeça: esses arquivos precisam dizer o que não fazer, não só o que fazer. "Não crie migration nova, use a que já existe em /db/migrations" evita um tipo de estrago que "siga as boas práticas" não evita. Instrução negativa e concreta é o que o agente respeita, e instrução genérica é o que ele interpreta do jeito que der na sessão.
Qual é a ordem das fases, e por que pular uma custa caro?
Ideia
  → Discovery (o que existe, o que já foi tentado)
  → PRD.md
  → ARCHITECTURE.md
  → AGENTS.md / CLAUDE.md
  → Epic
  → Tasks atômicas com acceptance criteria
  → worktree por raia
  → agente executa
  → o outro agente revisa
  → testes
  → quality gates
  → merge
  → atualiza a documentação
A fase que todo mundo pula é o Discovery, e é a que mais custa. Discovery é olhar o que já existe antes de mandar construir. Metade das vezes que eu vi agente produzir código redundante, a causa foi essa: ninguém disse para ele que aquilo já estava resolvido em outro canto do repositório. A segunda mais pulada é atualizar a documentação depois do merge. Parece burocracia, só que é o que mantém o ciclo funcionando, porque documento desatualizado é pior que documento inexistente, já que o agente confia nele.
Como quebrar epic em tasks atômicas com acceptance criteria?
Task boa para agente tem três propriedades: cabe numa sessão, não depende de outra task rodando ao mesmo tempo, e tem um critério objetivo de pronto. O teste que eu uso é simples: se eu não consigo escrever a frase "está pronto quando" sem usar "funcionar bem" ou "estar correto", a task ainda está grande demais ou vaga demais. Task ruim: "implementar autenticação". Task boa: "o endpoint POST /login devolve 200 com um JWT válido de 15 minutos quando as credenciais batem, e 401 sem corpo quando não batem, com teste cobrindo os dois casos".
A segunda é chata de escrever, eu sei. Só que é ela que permite aceitar ou rejeitar o trabalho do agente em dez segundos em vez de ler o diff inteiro. É a mesma lógica de PRD e tasks com Claude Code: o critério de aceite escrito antes é o que transforma revisão em conferência.
Como manter Claude Code e Codex no mesmo repositório sem conflito?
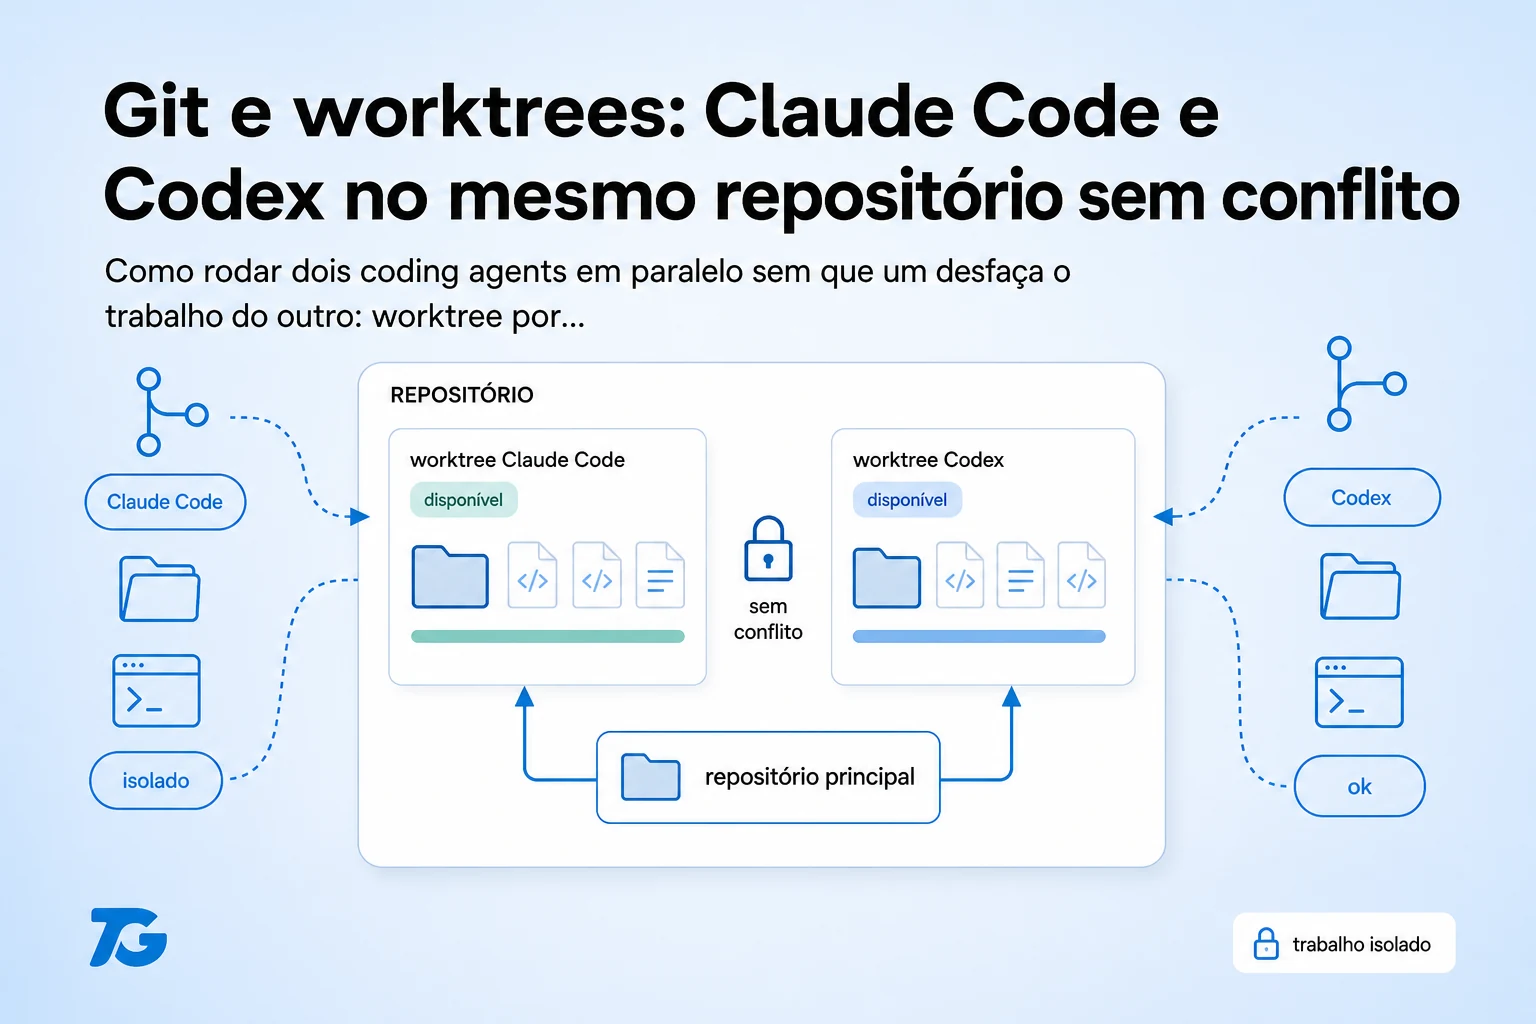
O que resolve é git worktree. Cada agente trabalha numa cópia própria do repositório, na sua branch, e eles nunca escrevem no mesmo arquivo ao mesmo tempo. O erro que eu cometi no começo foi achar que dava para rodar os dois na mesma pasta se as tasks fossem diferentes. Não dá: um roda um comando que mexe em node_modules, o outro está no meio de um build, e você perde os dois trabalhos. A regra é uma raia por worktree, desenhada na hora de quebrar as tasks. Se duas tasks tocam o mesmo arquivo, elas não são paralelas, e o detalhe está em Git e worktrees em paralelo.
Que quality gates rodar antes de aceitar o diff do agente?
Gate é o que roda sozinho e diz sim ou não, sem eu precisar julgar. A lista mínima: typecheck e lint, que é onde mais pega coisa, porque agente escreve código que parece certo e não compila com mais frequência do que se imagina. Testes, incluindo o que a task prometeu: se o critério falava em 401 sem corpo, tem que existir teste do 401 sem corpo. Diff de escopo, porque quando ele encosta em arquivo fora do previsto quase sempre entendeu outra coisa.
E a revisão pelo outro agente, que é o gate que mais rende. Eu mando o Codex revisar o que o Claude Code escreveu, e vice-versa. Eles erram de jeitos diferentes, então um pega o que o outro deixou passar. Não substitui a minha leitura, reduz o quanto eu preciso ler, e é o último filtro antes do merge em todo projeto meu.
O que é context engineering, e por que ele importa mais que o prompt?
Context engineering é decidir o que entra na janela do agente e o que fica de fora. Prompt é o que você pede, contexto é o que ele sabe na hora de atender. A intuição errada é achar que mais contexto é melhor. Contexto demais dilui: o agente lê trinta arquivos, dois são relevantes, e a atenção se espalha nos outros vinte e oito. Já vi resultado piorar por eu ter dado documentação demais.
O que funciona é contexto curado. A pasta da feature, o ARCHITECTURE.md, o DECISIONS.md, e só. Se ele precisar de mais, ele pede, e aí você dá o pedaço específico. É por isso que a estrutura de arquivos lá de cima importa tanto: ela não é organização por estética, é o mecanismo que permite entregar pouco e certo em vez de muito e vago.
Quando essa disciplina toda é exagero?
Sendo honesto, na maior parte das vezes que você abre o editor. Script de uma vez, protótipo para validar ideia, ajuste de CSS, automação pessoal que só você usa: nada disso precisa de PRD, e botar processo ali é dar razão para quem acha que isso é burocracia. O corte, na minha experiência, é este: se o projeto vai durar mais de uma semana, se mais de uma pessoa vai encostar nele, ou se vai para produção com dado de gente de verdade, compensa. Abaixo disso, vibe coding é a ferramenta certa.
A parte difícil é perceber a hora da virada, porque ela não avisa. Ela se manifesta como aquele cansaço de reexplicar a mesma coisa para o agente pela terceira vez. Quando você sentir isso, o projeto já passou do ponto faz uns dias, e o custo de organizar só cresce daí para frente.
Por onde começar amanhã?
Não monte a estrutura inteira de uma vez, você vai abandonar. Comece por dois arquivos: DECISIONS.md e AGENTS.md, mais o CLAUDE.md com o mesmo conteúdo. O DECISIONS.md porque dá retorno na primeira semana, você para de rediscutir. O AGENTS.md porque faz o agente parar de inventar convenção. PRD e a árvore de features você acrescenta quando doer a falta, e vai doer na hora em que uma feature ficar grande demais para caber numa mensagem. O processo inteiro, com as oito etapas até o deploy, está em como construir um SaaS com Claude Code e Codex.