Neste artigo
- O que precisa estar resolvido antes do primeiro deploy?
- Como deixar a imagem pequena e sem coisa demais dentro?
- O que multi-tenant muda no deploy?
- Por que reverter precisa ser mais fácil que corrigir?
- Qual o mínimo de observabilidade para dormir tranquilo?
- Do deploy até o primeiro cliente pagante, o que falta?
- Perguntas frequentes
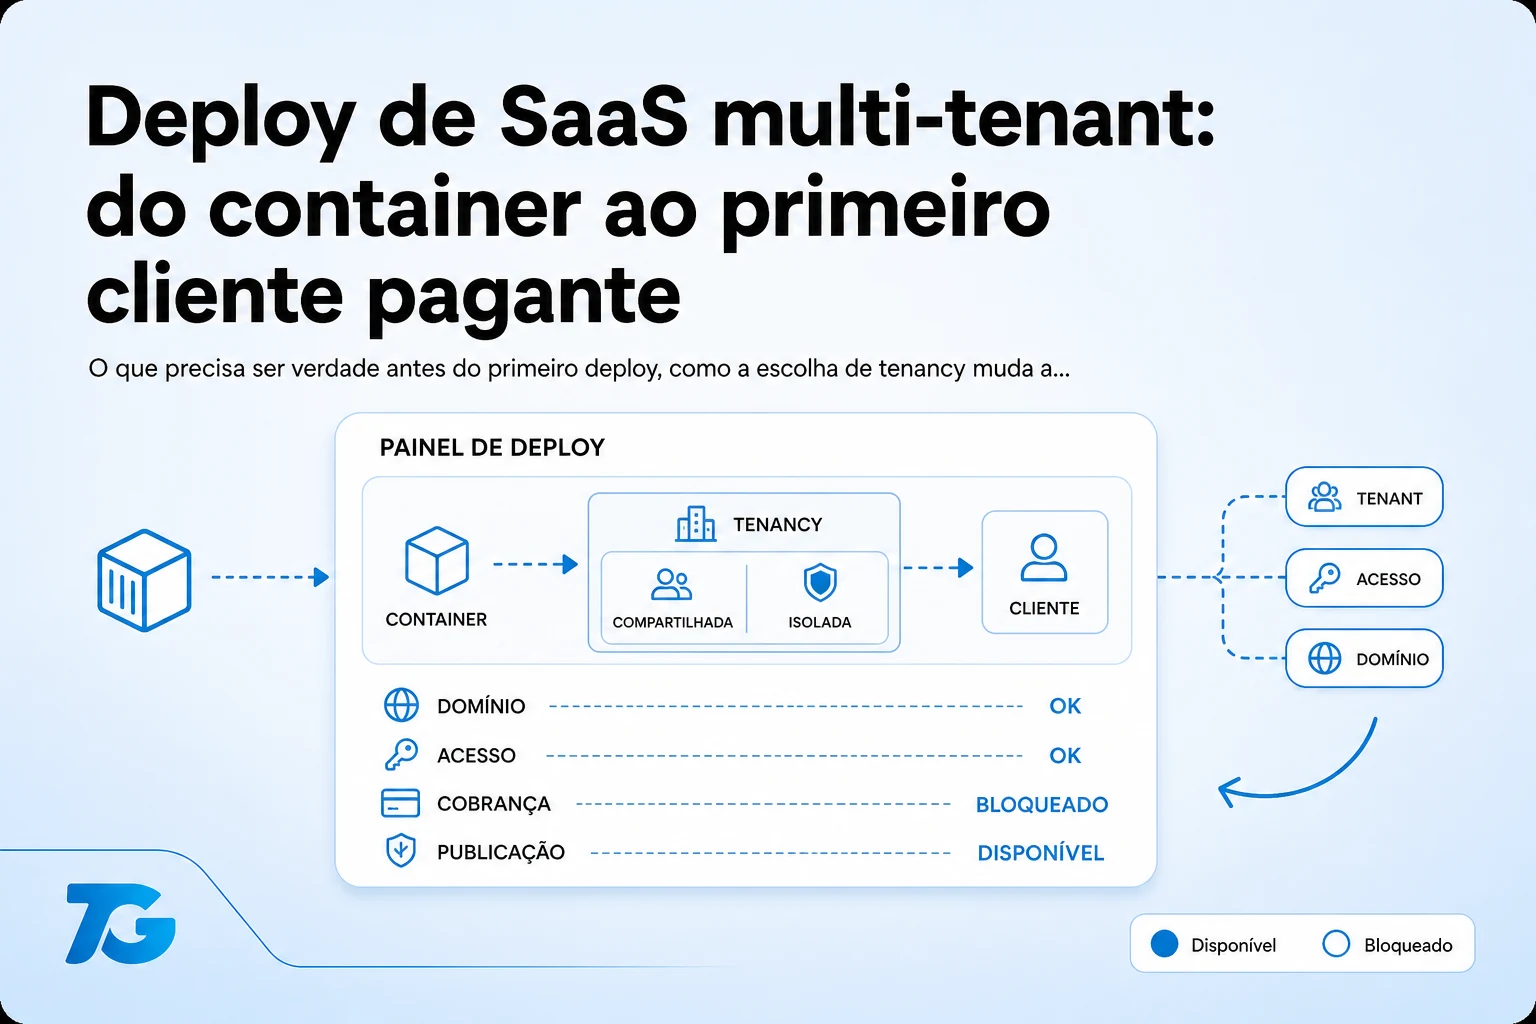
Colocar um SaaS multi-tenant no ar não exige Kubernetes nem time de infra. Exige container que sobe igual em qualquer lugar, um lugar onde o estado mora fora do container, deploy que dá pra reverter, e observabilidade suficiente pra você saber que quebrou antes do cliente avisar.
Eu rodo os meus com Docker, EasyPanel numa VPS, GitHub Actions no build e Cloudflare na frente. Não porque seja a stack mais moderna, mas porque é a que eu consigo operar sozinho às duas da manhã.
O que precisa estar resolvido antes do primeiro deploy?
Deploy é a parte fácil. O que dá trabalho é o que precisa ser verdade antes.
- Nada de estado no container. Sessão, cache, upload e job em andamento fora dele. Se estiver dentro, você não pode reiniciar sem perder coisa, e não pode ter duas instâncias.
- Configuração por variável de ambiente. Nenhum valor de ambiente compilado na imagem.
- Migration como passo separado. Nunca no start do container, senão duas instâncias subindo rodam a mesma migration ao mesmo tempo.
- Health check que checa dependência. Um endpoint que só devolve 200 não serve, ele precisa confirmar banco e fila.
Como deixar a imagem pequena e sem coisa demais dentro?
O Dockerfile que o agente escreve costuma funcionar e vir gordo: imagem base completa, dependências de desenvolvimento junto, e o processo rodando como root.
O que eu sempre ajusto: build em múltiplos estágios pra não levar toolchain pro final, imagem base enxuta, usuário sem privilégio, e as dependências instaladas antes de copiar o código, pra aproveitar cache de camada.
# o que eu peco explicitamente
- multi-stage: build separado do runtime
- imagem final sem dependencia de desenvolvimento
- usuario nao-root
- deps instaladas antes do COPY do codigo (cache)
- HEALTHCHECK que confere banco e fila, nao so a porta
O que multi-tenant muda no deploy?
Se você escolheu coluna de tenant, o deploy é igual ao de qualquer aplicação: uma migration, um banco. É a razão principal pela qual esse modelo é o padrão na maioria dos casos, como discuti em arquitetura de SaaS antes de gerar código.
Se você escolheu schema por cliente, a migration precisa iterar por todos os schemas, e o processo tem que ser reentrante: se falhar no schema 14 de 30, rodar de novo não pode quebrar os 13 que já passaram.
| Modelo | Deploy | Migration | Cliente novo |
|---|---|---|---|
| Coluna de tenant | Comum | Uma vez | Insere linha |
| Schema por cliente | Comum | Itera schemas, reentrante | Cria schema e roda migrations |
| Banco por cliente | Comum | Orquestrada por banco | Provisiona banco |
Por que reverter precisa ser mais fácil que corrigir?
A pergunta que decide se o seu deploy é seguro: quanto tempo leva pra voltar à versão anterior. Se a resposta passa de poucos minutos, você vai hesitar em subir, e hesitar em subir é o que faz acumular mudança grande, que é justamente o que quebra.
Imagem versionada com tag imutável resolve o lado do código. O lado do banco resolve com a regra das duas etapas: mudança destrutiva só depois que o código parou de usar, o que mantém a versão anterior funcionando com o schema novo. Está em banco de dados e migrations com agentes de IA.
Qual o mínimo de observabilidade para dormir tranquilo?
Não precisa de stack cara. Precisa de quatro coisas: log estruturado com identificador de tenant e de requisição, alerta de erro que chega no seu celular, monitor externo batendo no health check, e um painel simples de latência e taxa de erro.
O que eu não abro mão é do identificador de requisição atravessando tudo. Sem ele, investigar um caso de um cliente específico em log de produção vira arqueologia. Mais sobre isso em observabilidade em produção.
Do deploy até o primeiro cliente pagante, o que falta?
Entre estar no ar e cobrar tem uma lista curta que costuma ser subestimada: webhook de pagamento com assinatura verificada e idempotente, e-mail transacional saindo de domínio autenticado, política de privacidade e termos publicados, e um caminho de suporte que existe de verdade.
Webhook e e-mail são os dois que mais quebram na estreia. Webhook porque só é testado de verdade quando entra dinheiro real, e e-mail porque sem autenticação de domínio ele vai direto pro spam e o cliente jura que não recebeu.
Perguntas frequentes
VPS ou plataforma gerenciada?
Comece pelo que você consegue operar. Plataforma gerenciada custa mais por mês e economiza noites. VPS com um painel em cima é o meio termo que eu uso, porque me dá controle sem me obrigar a escrever manifesto de orquestrador.
Preciso de CI desde o começo?
Precisa de build reprodutível desde o começo. CI completo pode vir depois, mas se o deploy depende da sua máquina, você já tem um problema de continuidade.
Quando isso vira grande demais pra um dev só?
Mais tarde do que parece. O que costuma estourar primeiro não é infra, é suporte e mudança de escopo. O processo inteiro está em como construir um SaaS com Claude Code e Codex.